网页排版设计一次搞定,多平台自动适配不再累
摘要
成本大头在排, 不在写, 多平台内容运营如此, 同一个的主题, 得推出公众号、知乎、百家号、头条号、搜狐号、CSDN、小红书七个版本之多, 各异的平台, 各有一套格式, 各有一套审核规则, 各得走一套发布流程。本文中将 OceanGTM Content Studio作为例子, 从内容源、渲染管线、平台适配层、发布状态机、索引跟踪五个层面, 把"一次排版、全平台就绪"的工程实现予以拆解。
一、问题:多平台运营为什么这么累
曾运营过内容矩阵的人都会有相同的感受, 那就是,写出一篇文章需要耗费一小时的时间, 而要将其适配到seven个平台, 则需花费一下午的时间。
三个层面产生差异, 其一为格式层, 公众号需 21:9 封面且采用墨滴排版, 其支持 Markdown 表格, 头条跟搜狐要求纯文字 , CSDN要求完整Markdown, 小红书是3:4图文并附带十个关键词格式规定、其二是规则层层, 百家号禁止使用极限词, 搜狐号甚至连用品牌名与链接都展开拒审, 头条强制要求AI生成内容进行标注, 公众号则需查看资质、其三为流程层, 每个平台在发布之后还得回填 URL;跟踪收入情况;同时记录失败原因。
拿着手去重复地做这些事情, 一旦出现一次错误那便是一个拒审。那采用工程化的思路是这样的哟: 要使得系统去记住涵盖了所有平台的规则, 而人仅仅只负责内容部分。
二、从 SEO 到 GEO:排版为什么成了技术活
在传统SEO的那个时期, 排版所影响的乃是“网页于搜索结果呈现当中的排名情况”。处于GEO也即是生成式引擎优化的时代, 排版所影响的是“品牌在AI给出的回答里面被加以引用的可能性”, 二者所处维度全然不一样。
AI阅读内容的方式, 与搜索引擎不同。它抓取页面之后, 所做的事情是, 进行语义匹配, 也就是通过向量检索找出意图相近的片段, 还要做多源验证, 看看同一事实在不同平台是否一致, 再进行结构化提取, 比如标题层级、列表、表格、FAQ是否机器可读, 最后还会做权威性评分, 判断内容来自哪个域名、哪个作者。
这产生了两个有关技术方面的结论, 其一, 内容绝对需要呈现出结构化的状态, 像是答案先行的那种撰写方式, 清晰明确的标题层次级别, 以列表加上表格形式展现的数据呈现形式, 这些通通都是给予AI方便提取的钩子。其二, 在众多不同平台上的内容务必要保持一致, 当AI进行多源验证操作的时候, 网站的官方页面、知乎、百家号、领英所讲述的得是同一个事实情况, 如此引用之后置信程度才会比较高。这便是“排版器”所具备的存在价值, 它并非是起到美化作用的工具, 而是GEO的工程化基础设施。
三、系统设计:单一内容源加三层管线
核心设计原则:内容只写一遍,渲染和适配交给系统。
3.1 内容源:Markdown 作为单一事实源
存储的是所有以Markdown形式存在的内容, 之所以选择Markdown, 存在着三个缘由, 其一, 它是可供版本管理的纯文本, 其二, 它便于AI生成, 其三, 一份源文件能够被渲染成所有平台所需呈现出的种种形态, 诸如HTML、纯文本以及公众号排版。
3.2 渲染管线:解析、高亮、消毒三步
渲染管线是排版器的核心,三个环节缺一不可:
// 渲染管线:Markdown -> 安全 HTML
import { marked } from 'marked';
import hljs from 'highlight.js/lib/core';
import DOMPurify from 'dompurify';
marked.setOptions({
  breaks: true,   // 支持 GitHub 换行
  gfm: true,      // 支持表格、任务列表等 GFM 语法
  highlight(code, lang) {
    // 代码高亮:按语言注册,避免全量引入拖慢加载
    return hljs.getLanguage(lang)
      ? hljs.highlight(code, { language: lang }).value
      : code;
  }
});
export function renderMarkdown(text = '') {
  // DOMPurify 消毒:AI 生成内容必须过 XSS 过滤
  return DOMPurify.sanitize(marked.parse(String(text || '')), {
    ADD_ATTR: ['target', 'rel'],
  });
}
三个细节值得展开。
一、代码高亮是按照实际需求来注册语言的, 比如说javascript, json, python, bash, xml, css, 还有markdown, 而不去进行hljs的全量引入, 如此一来, 首屏的体积以及渲染的速度都是受到可控的。
第二, DOMPurify消毒是个硬性的环节, 内容是由AI生成以及人工撰写混合而成的, AI输出当中有可能会夹杂着危险的HTML片段, 要是不过滤直接进入页面那就是存储型XSS, 消毒放置在渲染出口处, 以此保证任何来源的内容在进入DOM之前都能被清洗。
首先, 是第三点, 当GFM语法被开启之后, 像表格、任务列表以及删除线这类具有GitHub风格的语法, 都能够进行解析, 这一点具有相当重要的意义, 它直接决定了, 对于知乎、CSDN这类支持富文本的平台而言, 最终能够拿到怎样的排版结果。
3.3 平台适配层:账号矩阵与内容类型
渲染出 HTML 之后,进入平台适配层。这里维护三张表。
平台别名表, 其作用是将源自不同地方的平台标识予以归一化处理, 像把“gzh”以及“公众号”, 统一映射为微信公众号这般, 以此来防止同一个平台在系统当中呈现出多种不同的写法。
账号矩阵表记载着, 各个平台的账号名称, 以及logo, 还有推荐内容类型。不同平台的账号存在着不一样的调性, 矩阵表促使, “这个内容应该发布到哪个账号, 并且以怎样的形态去发布”, 转变为配置而非记忆。
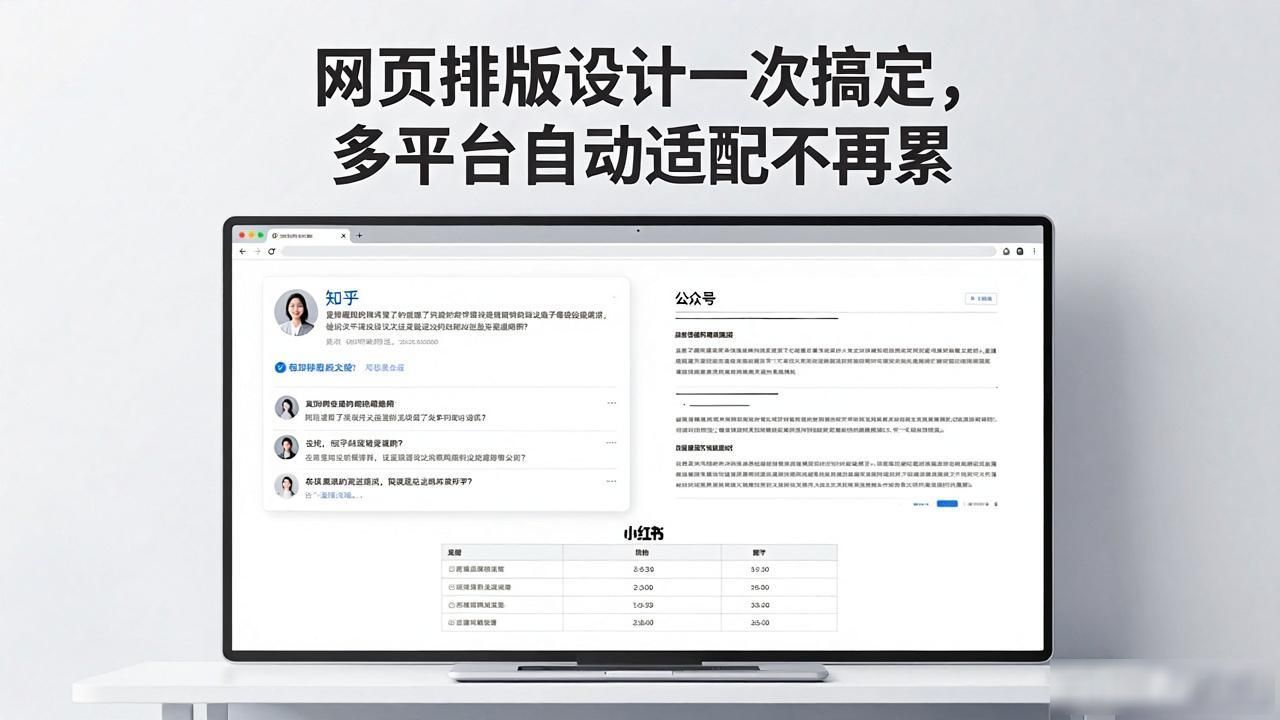
各类内容形态有, 问答卡、对比表还有那些案例内容等, 它们和平台相匹配了, 其中知乎适宜问答卡, 公众号适合案例长文, 小红书合适对比表图文, 随后适配层依据类型给出了建议, 最终是人来做出进一步决定的。
四、发布流程:状态机设计
完成排版并不等同于完成发布, 发布乃是一个需要人工进行介入的流程, 此流程具备可追踪的特性, 同时还具备可回滚的特性, 运用状态机来实施管理是最为合适的。
4.1 状态定义
review_required -> queued -> published
                     |          |
                     v          v
                  cancelled   failed
存在五个状态分别是, 待审核也就是review_required, 排队中即queued, 已发布为published, 失败是failed, 已取消乃cancelled。
遵循的流转规则是, 当内容简报经过审核通过之后开启任务创建流程而迈向待审核阶段, 在此阶段, 由人工实行审核且达到通过标准就步入排队状态, 待人工发布完结之后就会注入真实的 URL 并加以确认, 随后进程转变为已发布, 要是发布遭遇失败便会纪录下具体原因从而进入失败态, 这种情况下是能够进行重试操作的, 处于待审核以及排队状态下的任务具备可被取消的特性。
4.2 非法流转拒绝
最为关键的并非状态机所许可的内容, 而是其予以拒绝的部分。系统之中的全部流转路径, 无一例外均要历经统一的校验环节。一旦出现非法流转情况, 便会直接返回 422:
# 状态机校验:非法流转直接拒绝
try:
    require_publish_transition(task.status, "queued")
except InvalidPublishTransition as exc:
    raise HTTPException(status_code=422, detail=str(exc))
有一种情况是, 像那种已经被发布了的任务, 是不能够再返回到进行排队的状态的;还有, 那种已经被取消掉了的任务呢, 也不可以直接转变为已发布了的状态。这样的一种约束, 在一定程度上保证了发布记录能够成为可信的审计日志, 而并非是那种可以被随意进行更改的字段。
4.3 数据校验
存在两个硬性校验值, 这是值得予以强调的。其中, 回填 URL 是必填项, 原因在于系统并非是以“点了发布按钮”来当作发布成功的标志, 而是得必须以真实 URL 回填作为标准, 要杜绝出现假发布的情况。另外, 发布前是必须指定审核人的, 因为内容进入公开渠道之前, 必定得有人对结果负责。
五、索引跟踪:发布不是终点
内容被发布之后, GEO工作方才刚开始, 系统针对每个发布任务保持索引状态。
pending(等待收录)-> indexed(已收录)/ not_indexed(未收录)/ unknown(未知)
这个状态字段的意义是, 将“发布”与“被收录”这两件事区分开来进行记账, 很多团队存在这样的误区, 他们把文章发出去就当作完成了, 实则不然, Google 、百度、Bing 的爬虫是否抓取、是否收录, 以及收录后排名怎样, 这是一条完全独立的链路, 发布以后跟踪索引状态, 方能回答“我们发的内容究竟有没有被搜索引擎和 AI 爬虫获取到”。
索引跟踪通过主动推送(IndexNow 提交 Bing、百度主动推送 API)以及 sitemap 更新相结合, 形成了发布链路的数据闭环, 发布, 推送之后会有收录, 接着是回填状态, 最后进行复测排名。
六、GEO 视角:这套系统的价值在哪
从 GEO 的角度看,排版器解决的是三个长期问题。
把内容转化为资产, 全部内容凭借Markdown单一事实源来进行沉淀, 不依靠任何平台的编辑器, 不管是更换平台, 变动账号, 还是更换服务商, 内容资产都能够带走。
展现一致性的信号, 将同一内容遵循平台规则适配好之后分别发布到多个阵地, 当AI进行多源验证的阶段, 映入视觉的是同一个品牌在叙述同一件事情, 并且引用置信度随着阵地数量的增多而有所上升, 这种情况要比在单平台进行堆量有效的程度高很多。
数据形成闭环, 内容简报环节, 进而审核环节, 再到发布环节, 接着URL回填环节, 直至索引状态, 每一个步骤皆存在相应记录, 哪个平台在收录方面速度快、哪个平台常常处于审核被拒的情形、哪一类内容较为容易被引用, 全部能够通过对数据的仔细观察分析而呈现出来得知, 并非凭借主观且随意的感觉。
七、结语
工程化呈现于多平台运营之内, 其本质是将”人的经验“转化为”系统的规则“。作为这类工具之一的排版器, 重点不在于节省了半小时排期时间成本, 着眼处是它在生成内容的表现, 是从发布普通单品上升成了运营一组系统流程, 这便构成了可跟踪检索, 允许循环运用, 并使得传播要素清晰可溯的内容资产系统。在AI检索横行之社会环境下, 这套成型之资源体系本身便足以架构并稳固竞争藩篱。
盈帆 - OceanGTM 的内容排版工作台是 OceanGTM Content Studio, 它针对外贸企业多平台内容运营场景。
 请小编喝杯咖啡吧!